Apple viserait une production en série de puces IA pour serveurs au second semestre 2026, puis de nouveaux data centers en 2027. Le projet Baltra ferait sortir Apple Silicon du Mac, mais Apple n’a encore publié ni fiche technique ni benchmark.
Le calendrier envisagé est précis : une production entre juillet et décembre 2026suivie par la construction et la mise en service de nouvelles infrastructures en 2027. Apple n’a toutefois confirmé ni la puce, ni son nom de code, ni sa date commerciale. Pour l’instant, il s’agit d’un scénario industriel, pas d’un composant prêt à rejoindre la prochaine keynote.
Le projet intervient alors que l’entreprise doit accélérer sur l’IA générative. Les fonctions d’Apple Intelligence utilisent déjà un mélange de traitement local et de calcul distant. La prochaine étape consisterait à mieux contrôler les serveurs qui prennent le relais quand l’iPhone, l’iPad ou le Mac ne suffit plus.
Le M prend le large, mais pas votre Mac
Apple utilise déjà ses propres processeurs dans les serveurs associés à Private Cloud Compute. En septembre 2024, Craig Federighi expliquait que cette infrastructure reposait sur des serveurs équipés d’Apple Silicon. Apple y traite certaines requêtes d’Apple Intelligence à distance, avec une architecture conçue pour protéger les données et le chiffrement des échanges.
Baltra changerait de catégorie. Le projet serait distinct de la gamme M et conçu d’abord pour l’inférence IA en data center, avec des charges continues et un grand nombre de requêtes simultanées. Le cahier des charges ne ressemble donc pas à celui d’une puce de portable : il faut surveiller le débit, la consommation par opération et la dissipation thermique.
Apple ne cherche plus seulement à concevoir le processeur du produit, mais aussi celui qui travaille derrière le produit. Le jardin clos pourrait ainsi s’étendre du terminal jusqu’au cloud qui l’alimente.
Baltra croque le cloud
Les informations disponibles associent Baltra à un développement mené avec Broadcom. La puce viserait les modèles d’IA exécutés dans les infrastructures Apple, sans remplacer les processeurs M installés dans les appareils de la marque. Cette séparation permettrait d’adapter le silicium aux besoins du serveur au lieu de prolonger simplement une architecture conçue pour un ordinateur personnel.
Apple pourrait travailler sur trois paramètres très concrets : le débit de calcul, l’énergie consommée par requête et la gestion thermique dans les racks. Aucun chiffre Apple ne permet encore de mesurer ces gains. Il n’existe ni score de benchmark, ni fréquence, ni procédé de gravure, ni consommation publiée. Transformer cette rumeur industrielle en bond de performance sur graphique Excel serait donc du flan.
Le mouvement s’inscrit dans une stratégie plus large d’intégration. Apple a déjà présenté les modems cellulaires C1 et C1X, ainsi que la puce de connectivité N1. En internalisant progressivement ces composants, l’entreprise contrôle davantage l’intégration matérielle, les logiciels et le calendrier de production. Le même raisonnement appliqué aux serveurs pourrait réduire sa dépendance envers les fournisseurs spécialisés, à condition de tenir la cadence.
Houston, on a un serveur
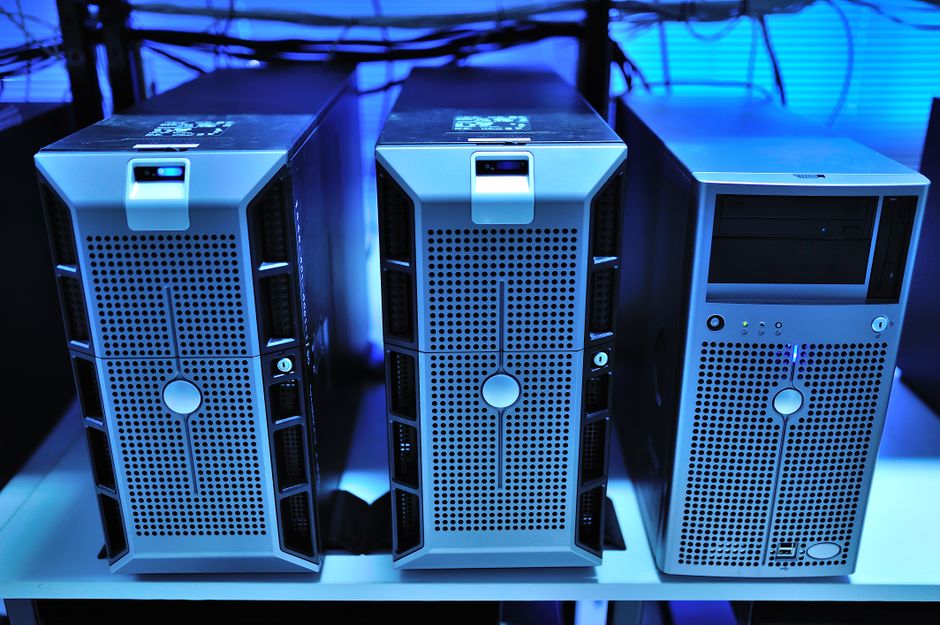
Apple a annoncé à Houston un site consacré à la fabrication de serveurs IA destinés à Private Cloud Compute. En octobre 2025, l’entreprise a indiqué que le site fonctionnait déjà et que les premiers serveurs fabriqués aux Etats-Unis avaient commencé à être expédiés. Ces machines doivent alimenter Apple Intelligencepas accélérer le prochain MacBook posé sur un bureau.
Le scénario associé à Baltra prévoit une première utilisation dans les data centers existants, avant l’arrivée de nouvelles installations en 2027. Cette progression permettrait de déployer les puces par étapes, sans attendre la fin d’un chantier complet. Le matériel, les bâtiments et les logiciels doivent avancer ensemble. Ça négocie sévère à tous les étages.
Siri cherche son serveur
Photo de İsmail Enes Ayhan sur Unsplash.
Le dossier prend une autre dimension avec le partenariat entre Apple et Google autour de Siri et Gemini. Apple peut s’appuyer sur des modèles et une capacité de calcul externes pour accélérer ses fonctions d’IA, tout en développant une infrastructure destinée à reprendre davantage de contrôle à moyen terme.
Cette coexistence ressemble à une période de transition. Google fournit une solution immédiate, tandis que Baltra préparerait une capacité interne mieux adaptée aux services d’Apple. Le calendrier laisse penser que le partenariat achète du temps pendant qu’Apple construit son propre socle matériel.
La confidentialité demande toutefois une analyse plus précise. Une puce conçue par Apple ne garantit pas à elle seule qu’une requête reste privée. La protection dépend de l’architecture complète, du chiffrement, des journaux techniques et des règles appliquées aux données. Le logo gravé sur le serveur ne fera pas tout le travail.
Les accélérateurs IA passent au banc d’essai
Les travaux scientifiques montrent pourquoi le matériel spécialisé ne suffit pas sans logiciel adapté. Une étude publiée en 2024 dans Journal of Chemical Theory and Computation a obtenu environ 115 TFLOPS sur un nœud équipé de huit NVIDIA A100 dans des calculs de chimie quantique. Les auteurs indiquent avoir atteint 71 % de la capacité théorique du matériel dans le cadre testé.
Ce résultat ne mesure ni Baltra ni l’inférence d’Apple Intelligence. Il rappelle simplement qu’un accélérateur dépend des algorithmes, de la précision numérique, des compilateurs et de la capacité du programme à exploiter ses unités de calcul. Une autre étude publiée en 2025 dans la même revue a testé des configurations DGX-A100 et DGX-H100 pour optimiser des calculs de chimie quantique sur de grands espaces actifs. Là encore, le domaine et les méthodes ne permettent pas de transposer directement les performances à un serveur Apple.
Un bon accélérateur ne suffit pas : il faut aussi des modèles et des outils capables de l’occuper. Apple devra donc aligner la puce, les compilateurs, les modèles et les services. Sinon, le rack héritera d’un très beau morceau de silicium qui attend sagement qu’on lui donne du travail.
Le jardin clos monte en rack
Avec Baltra, Apple chercherait à prolonger son intégration verticale jusque dans les data centers. La firme contrôlerait une chaîne allant de la puce installée dans l’appareil aux serveurs qui prennent le relais lorsque le traitement local atteint ses limites. Cette continuité peut simplifier l’optimisation, mais elle augmente aussi les investissements, la maintenance et la complexité opérationnelle.
Le pari est double : rendre Apple Intelligence plus compétitive face aux services cloud existants et conserver la maîtrise des données et des coûts de calcul. La production annoncée pour le second semestre 2026 serait le premier jalon, les nouvelles infrastructures de 2027 le suivant. Pour l’instant, Baltra reste un nom de code et 2026 un calendrier à vérifier. Les data centers, eux, ne démarrent pas avec une phrase de keynote.
Sources et références scientifiques
Malcolm Owen. Ming-Chi Kuo: Apple will get serious about AI server chips in 2026. 2026.
Tensor Network State Algorithms on AI Accelerators – PMC. Journal of chemical theory and computation. DOI: 10.1021/acs.jctc.4c00800 · PMID: 39399903.
Xu X.; Benjamin S.; Sun J.; Yuan X.; Zhang P.. A Herculean task: Classical simulation of quantum computers. arXiv:2302.08880 2023. 10.48550/arXiv.2302.08880. [DOI] [PubMed]. doi:10.48550/arXiv.2302.08880.
Nassif N.et al. Sapphire Rapids: The Next-Generation Intel Xeon Scalable Processor. In 2022 IEEE International Solid- State Circuits Conference (ISSCC), 2022; pp. 44-46..
Burd T.et al. Zen3: The AMD 2nd-Generation 7nm x86-64 Microprocessor Core. In 2022 IEEE International Solid- State Circuits Conference (ISSCC), 2022; pp. 1-3..
Munger B.et al. Zen 4”: The AMD 5nm 5.7 GHz x86-64 Microprocessor Core. In 2023 IEEE International Solid- State Circuits Conference (ISSCC), 2023; pp. 38-39..
Elster A. C.; Haugdahl T. A. Nvidia Hopper GPU and Grace CPU Highlights. Computing in Science & Engineering 2022, 24, 95-100. 10.1109/MCSE.2022.3163817. [DOI] [Google Scholar]. doi:10.1109/MCSE.2022.3163817.
Svedin M.; Chien S. W. D.; Chikafa G.; Jansson N.; Podobas A.. Benchmarking the Nvidia GPU Lineage: From Early K80 to Modern A100 with Asynchronous Memory Transfers. In HEART '21: Proceedings of the 11th International Symposium on Highly Efficient Accelerators and Reconfigurable Technologies, 2021; pp. 1-6..
Jouppi N. P.; Young C.; Patil N.; Patterson G. A.D.; Bajwa R.; Bates S.; Bhatia S.; Boden N.; Borchers E. A. A.. Proceedings of the 44th Annual International Symposium on Computer Architecture, ISCA ′17; Association for Computing Machinery: New York, NY, USA, 2017, p. 1..
Jouppi N. P.; Yoon D. H.; Kurian G.; Li S.; Patil N.; Laudon J.; Young C.; Patterson D. A Domain-Specific Supercomputer for Training Deep Neural Networks. Commun. ACM 2020, 63, 67-78. 10.1145/3360307. [DOI] [Google Scholar]. doi:10.1145/3360307.
Feynman R. P. The Theory of Positrons. Phys. Rev. 1949, 76, 749-759. 10.1103/PhysRev.76.749. [DOI] [Google Scholar]. doi:10.1103/PhysRev.76.749.
Anzt H.; Bienz A.; Luszczek P.; Baboulin M.. High Performance Computing. In ISC High Performance 2022 International Workshops: Hamburg, Germany, May 29-June 2, 2022, Revised Selected Papers; Lecture Notes in Computer Science; Springer International Publishing, 2023. [Google Scholar].
Hager G.; Jeckelmann E.; Fehske H.; Wellein G. Parallelization strategies for density matrix renormalization group algorithms on shared-memory systems. J. Comput. Phys. 2004, 194, 795-808. 10.1016/j.jcp.2003.09.018. [DOI] [Google Scholar]. doi:10.1016/j.jcp.2003.09.018.
Stoudenmire E. M.; White S. R. Real-space parallel density matrix renormalization group. Phys. Rev. B 2013, 87, 155137 10.1103/PhysRevB.87.155137. [DOI] [Google Scholar]. doi:10.1103/PhysRevB.87.155137.
Orbital Optimization of Large Active Spaces via AI-Accelerators – PMC. Journal of chemical theory and computation. DOI: 10.1021/acs.jctc.5c00571 · PMID: 40512221.
Neese F., Wennmohs F., Becker U., Riplinger C.. The ORCA quantum chemistry program package. J. Chem. Phys. 2020;152:224108. doi: 10.1063/5.0004608. [DOI] [PubMed] [Google Scholar]. doi:10.1063/5.0004608.
Aprà E.. et al. NWChem: Past, present, and future. J. Chem. Phys. 2020;152:184102. doi: 10.1063/5.0004997. [DOI] [PubMed] [Google Scholar]. doi:10.1063/5.0004997.
Werner H.-J., Knowles P. J., Knizia G., Manby F. R., Schütz M.. Molpro: a general-purpose quantum chemistry program package. WIREs Computational Molecular Science. 2012;2:242. doi: 10.1002/wcms.82. [DOI] [Google Scholar]. doi:10.1002/wcms.82.
Frisch, M. J. et al. Gaussian 16 Revision C.01; Gaussian Inc.: Wallingford CT, 2016. [Google Scholar].
Shao Y.. et al. Advances in molecular quantum chemistry contained in the Q-Chem 4 program package. Mol. Phys. 2015;113:184. doi: 10.1080/00268976.2014.952696. [DOI] [Google Scholar]. doi:10.1080/00268976.2014.952696.
te Velde G., Bickelhaupt F. M., Baerends E. J., Fonseca Guerra C., van Gisbergen S. J. A., Snijders J. G., Ziegler T.. Chemistry with ADF. J. Comput. Chem. 2001;22:931. doi: 10.1002/jcc.1056. [DOI] [Google Scholar]. doi:10.1002/jcc.1056.
Kresse G., Furthmüller J.. Efficient iterative schemes for ab initio total-energy calculations using a plane-wave basis set. Phys. Rev. B. 1996;54:11169. doi: 10.1103/PhysRevB.54.11169. [DOI] [PubMed] [Google Scholar]. doi:10.1103/PhysRevB.54.11169.
Sun Q.. et al. Recent developments in the PySCF program package. J. Chem. Phys. 2020;153:024109. doi: 10.1063/5.0006074. [DOI] [PubMed] [Google Scholar]. doi:10.1063/5.0006074.
Seritan S., Bannwarth C., Fales B. S., Hohenstein E. G., Isborn C. M., Kokkila-Schumacher S. I. L., Li X., Liu F., Luehr N., Snyder J. W. Jr, Song C., Titov A. V., Ufimtsev I. S., Wang L.-P., Martínez T. J.. TeraChem: A graphical processing unit-accelerated electronic structure package for large-scale ab initio molecular dynamics. WIREs Comput. Mol. Sci. 2021;11:e1494. doi: 10.1002/wcms.1494. [DOI] [Google Scholar]. doi:10.1002/wcms.1494.
Giannozzi P., Baroni S., Bonini N., Calandra M., Car R., Cavazzoni C., Ceresoli D., Chiarotti G. L., Cococcioni M., Dabo I.. et al. Quantum ESPRESSO: a modular and open-source software project for quantum simulations of materials. J. Phys.: Condens. Matter. 2009;21:395502. doi: 10.1088/0953-8984/21/39/395502. [DOI] [PubMed] [Google Scholar]. doi:10.1088/0953-8984/21/39/395502.
Giannozzi P., Andreussi O., Brumme T., Bunau O., Buongiorno Nardelli M., Calandra M., Car R., Cavazzoni C., Ceresoli D., Cococcioni M.. et al. Advanced capabilities for materials modelling with Quantum ESPRESSO. J. Phys.: Condens. Matter. 2017;29:465901. doi: 10.1088/1361-648X/aa8f79. [DOI] [PubMed] [Google Scholar]. doi:10.1088/1361-648X/aa8f79.
Giannozzi P., Baseggio O., Bonfá P., Brunato D., Car R., Carnimeo I., Cavazzoni C., de Gironcoli S., Delugas P., Ferrari Ruffino F.. et al. Quantum ESPRESSO toward the exascale. J. Chem. Phys. 2020;152:154105. doi: 10.1063/5.0005082. [DOI] [PubMed] [Google Scholar]. doi:10.1063/5.0005082.
A Performance Study of Deep Neural Network Representations of Interpretable ML on Edge Devices with AI Accelerators – PMC. Sensors (Basel, Switzerland). DOI: 10.3390/s25185681 · PMID: 41012919.
1.Mobley R.K. An Introduction to Predictive Maintenance. Elsevier; Amsterdam, The Netherlands: 2002. [Google Scholar].
2.Plevris V., Papazafeiropoulos G. AI in Structural Health Monitoring for Infrastructure Maintenance and Safety. Infrastructures. 2024;9:225. doi: 10.3390/infrastructures9120225. [DOI] [Google Scholar]. doi:10.3390/infrastructures9120225.
3.Rao B.k.n. Handbook of Condition Monitoring. Elsevier; Amsterdam, The Netherlands: 1996. [DOI] [Google Scholar].
4.Zhang J., Zhao Z., Zhang X., Wang Z. Energy Aware Edge Computing: A Survey. Comput. Commun. 2020;151:556-580. doi: 10.1016/com.2020.01.004. [DOI] [Google Scholar]. doi:10.1016/j.comcom.2020.01.004.
5.Kirianaki N.V., Yurish S.Y., Shpak N.O., Deynega V.P. Data Acquisition and Signal Processing for Smart Sensors. Wiley; New York, NY, USA: 2002. [Google Scholar].
6.Schütze A., Helwig N., Schneider T. Sensors 4.0, Smart Sensors and Measurement Technology Enable Industry 4.0. J. Sens. Sens. Syst. 2018;7:359-371. doi: 10.5194/jsss-7-359-2018. [DOI] [Google Scholar]. doi:10.5194/jsss-7-359-2018.
7.Singh R., Gill S.S. Edge AI: A Survey. Internet Things Cyber-Phys. Syst. 2023;3:71-92. doi: 10.1016/tcps.2023.02.004. [DOI] [Google Scholar]. doi:10.1016/j.iotcps.2023.02.004.
8.LeCun Y., Bengio Y., Hinton G. Deep Learning. Nature. 2015;521:436-444. doi: 10.1038/nature14539. [DOI] [PubMed] [Google Scholar]. doi:10.1038/nature14539.
9.Bavikadi S., Dhavlle A., Ganguly A., Haridass A., Hendy H., Merkel C., Reddi V.J., Sutradhar P.R., Joseph A., Dinakarrao S.M.P. A Survey on Machine Learning Accelerators and Evolutionary Hardware Platforms. IEEE Des. Test. 2022;39:91-116. doi: 10.1109/MDAT.2022.3161126. [DOI] [Google Scholar]. doi:10.1109/MDAT.2022.3161126.
10.Wang T., Wang C., Zhou X., Chen H. A Survey of FPGA-Based Deep Learning Accelerators: Challenges and Opportunities. IEEE Access. 2018;6:12345-12356. doi: 10.48550/arXiv.1901.04988. [DOI] [Google Scholar]. doi:10.48550/arXiv.1901.04988.
11.Park E., Kim D., Yoo S. Energy-Efficient Neural Network Accelerator Based on Outlier-Aware Low-Precision Computation; Proceedings of the 2018 ACM/IEEE 45th Annual International Symposium on Computer Architecture (ISCA); Los Angeles, CA, USA. 1-6 June 2018; pp. 688-698. [DOI] [Google Scholar].
12.Zhou Y., Zhang J., Zhang Y., Wang Y., Yang Y. A Comparative Study of Open Source Deep Learning Frameworks; Proceedings of the 2018 IEEE International Conference on Artificial Intelligence and Big Data (ICAIBD); Chengdu, China. 26-28 May 2018; pp. 1-5. [DOI] [Google Scholar].
Huang H, Shao W, Hammond J.. Accelerating Density Fitting with Adaptive Precision and 8-Bit Integer on AI Accelerators.. The journal of physical chemistry. A. 2026. DOI: 10.1021/acs.jpca.6c00225 · PMID: 41995411. (résumé scientifique structuré; texte intégral non fourni)
Skye Jacobs. Apple plans to mass-produce its first AI server chips in 2026. 2026.
Navi. Apple to begin mass production of in-house AI server chips in H2 2026 as Google deal buys time. 2026.
Bonjour ! Je suis Yves, un passionné de technologie et du web, âgé de 35 ans. J'adore explorer les innovations numérique et partager mes connaissances avec autrui. Mon objectif est d'aider chacun à naviguer dans l'univers digital avec aisance. Bienvenue sur mon site !
Nous utilisons des cookies pour vous garantir la meilleure expérience sur notre site web. Si vous continuez à utiliser ce site, nous supposerons que vous en êtes satisfait.