Le 18 décembre 2025quatre Mac Studio M3 Ultra ont montré qu’un Mac pouvait travailler en grappe avec 1,5 To de mémoire mutualisée. Le secret tient au RDMA de Thunderbolt 5, pas à une énième promesse de keynote sortie du chapeau.
Le jardin clos se met en grappe
Dans le test publié le 18 décembre 2025, Jeff Geerling a utilisé quatre Mac Studio prêtés par Apple. Chaque machine embarquait une puce M3 Ultra avec un CPU de 32 coeurs, un GPU de 80 coeurs et un Neural Engine de 32 coeurs. Deux modèles disposaient de 512 Go de mémoire unifiée et de 8 To de stockage, les deux autres de 256 Go et 4 To.
Le total atteint donc 1,5 To de mémoire et 24 To de stockage. Installés dans un rack de 10 pouces, les quatre ordinateurs consommaient moins de 250 watts chacun. Geerling les a décrits comme « almost whisper-quiet »autrement dit presque inaudibles. Pour une baie de machines capable de faire tourner des modèles de centaines de milliards de paramètres, ce n’est pas franchement la fanfare d’un serveur classique.
Le problème arrive sur l’étiquette. Cette configuration coûte un peu moins de 40 000 dollars. On n’est donc pas face au prochain achat malin pour remplacer un MacBook Air, mais devant une station de travail destinée à une équipe de recherche ou à une entreprise qui accepte de payer cher pour exploiter de gros modèles locaux.
Le changement de catégorie est simple : la mémoire des quatre Mac ne reste plus enfermée dans quatre boîtiers séparés.
80 Gb/s, ça ne se compte pas en pommes
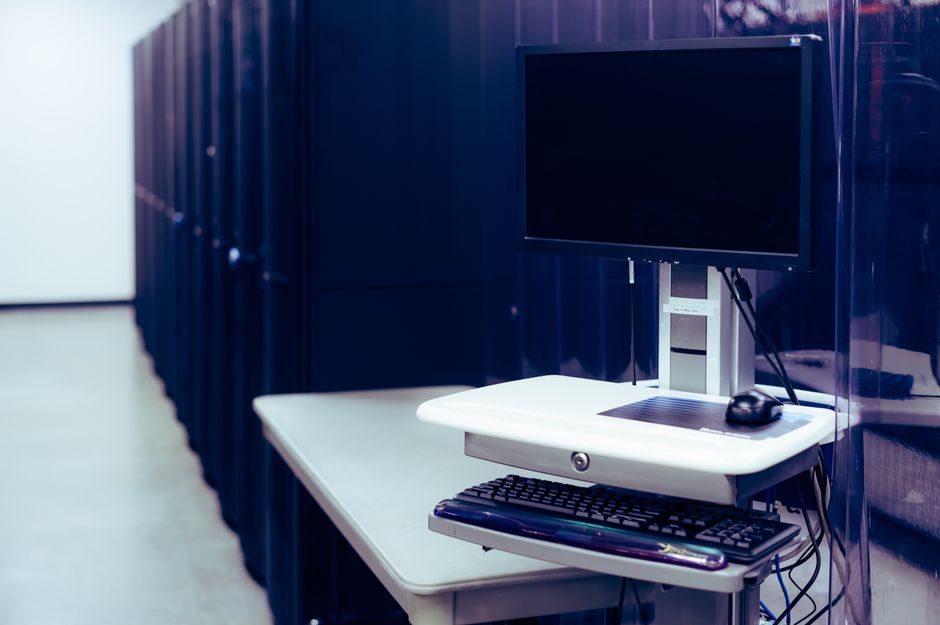
Photo de Randall Bruder sur Unsplash.
Le réseau Ethernet disponible sur ces Mac peut plafonner à 10 Gb/s dans cette configuration. Thunderbolt 4 montait à 40 Gb/s, tandis que Thunderbolt 5 double la bande passante maximale à 80 Gb/s. Cette différence devient importante quand plusieurs machines doivent s’échanger en permanence des poids de modèle, des activations et des données intermédiaires.
La version macOS Tahoe 26.2 apporte à MLXle framework d’apprentissage automatique d’Apple, un pilote compatible avec le clustering Thunderbolt 5. La mise à jour ajoute aussi la prise en charge des accélérateurs neuronaux du GPU. Ce détail bas niveau intéresse directement les chercheurs qui travaillent sur des LLM de taille massive.
La bande passante ne suffit pourtant pas. Une liaison rapide peut toujours perdre du temps si le processeur d’un noeud doit attendre qu’un autre noeud copie lentement ses données. C’est là que le RDMA, pour Remote Direct Memory Access, change le scénario.
RDMA, le Mac qui lit chez le voisin
Avec le RDMA, un noeud peut accéder directement à la mémoire d’un autre ordinateur sans mobiliser fortement le CPU de la machine distante. Les quatre Mac Studio présentent alors une réserve mémoire commune de 1,5 To au logiciel compatible. Ce n’est pas une fusion magique des ordinateurs, mais une façon de dépasser la capacité maximale d’un seul appareil.
La nuance compte. Un modèle trop volumineux pour tenir dans les 512 Go d’un Mac Studio peut être réparti sur plusieurs machines, mais la latence du réseau et l’organisation du logiciel restent déterminantes. Exo exploite le RDMA, tandis que Llama.cpputilisé dans les mêmes essais, ne le prend pas en charge. La comparaison mesure donc autant l’efficacité du logiciel de distribution que la vitesse brute du matériel.
Les benchmarks sortent du garage
Les résultats publiés par Jeff Geerling le 18 décembre 2025 montrent un comportement assez parlant. Avec Qwen3 235BLlama.cpp commence légèrement devant Exo sur un seul Mac. Dès que deux puis quatre noeuds entrent dans la danse, la situation s’inverse nettement.
Modèle
Noeuds
Outil
Vitesse
Qwen3 235B
1
Llama.cpp
20,4 tokens/s
Qwen3 235B
1
Exo
19,5 tokens/s
Qwen3 235B
2
Llama.cpp
17,2 tokens/s
Qwen3 235B
2
Exo
26,2 tokens/s
Qwen3 235B
4
Llama.cpp
15,2 tokens/s
Qwen3 235B
4
Exo
31,9 tokens/s
DeepSeek V3.1 671B
1
Exo
21,1 tokens/s
DeepSeek V3.1 671B
2
Exo
27,8 tokens/s
DeepSeek V3.1 671B
4
Exo
32,5 tokens/s
Kimi K2 Thinking 1T A32B
2
Llama.cpp
18,5 tokens/s
Kimi K2 Thinking 1T A32B
2
Exo
21,6 tokens/s
Kimi K2 Thinking 1T A32B
4
Exo
28,3 tokens/s
Sur Qwen3 235BExo passe de 19,5 tokens par seconde sur un noeud à 31,9 sur quatre. Dans le même temps, Llama.cpp recule de 20,4 à 15,2 tokens par seconde. Le cluster n’accélère donc pas automatiquement tous les logiciels : il récompense celui qui sait utiliser la mémoire distante.
DeepSeek V3.1 671B confirme cette tendance avec Exo : 21,1 tokens/s sur un Mac, 27,8 sur deux et 32,5 sur quatre. Le test du modèle Kimi K2 Thinking 1T A32B est encore plus révélateur. Son architecture compte un millier de milliards de paramètres, même si 32 milliards sont actifs à la fois, et il dépasse la capacité d’un seul Mac Studio équipé de 512 Go de mémoire.
Le gain n’est donc pas un joli score de benchmark : c’est la possibilité de charger des modèles qui ne rentrent tout simplement pas dans une seule machine.
40 000 dollars, la grappe qui pique
Photo de Amanz sur Unsplash.
A moins de 40 000 dollars, cette configuration reste hors de portée de la plupart des particuliers. Le coût comprend les quatre Mac Studio et leurs capacités mémoire et stockage élevées, mais il ne résume pas une infrastructure complète : il faut encore gérer le logiciel, le stockage des modèles, la maintenance et l’alimentation.
Le rapport performance-prix dépend donc du contexte. Pour tester un modèle géant en local, quatre Mac peuvent offrir une alternative à l’achat ou à la location d’une infrastructure spécialisée. Pour simplement faire tourner un assistant conversationnel, l’addition ressemble plutôt à un tir dans le pied avec une carte bancaire. Le fan absolu de la rédac apprécie le silence du rack, mais il a cessé de regarder le relevé bancaire depuis le troisième Mac.
Le câble n’a pas encore gagné la guerre du réseau
Thunderbolt 5 impose une limite physique à cette démonstration. En l’absence de commutateur Thunderbolt 5 adapté à ce scénario, les quatre Mac Studio doivent être reliés en chaîne. Plus la chaîne s’allonge, plus la latence risque de pénaliser les échanges entre noeuds. On est loin d’un cluster extensible à volonté.
Des problèmes de stabilité ont aussi été signalés lors de benchmarks HPL exécutés au-dessus de Thunderbolt, avec des bugs liés à des logiciels encore en développement. Le résultat de décembre 2025 est donc solide comme démonstration, mais il ne constitue pas une garantie de déploiement industriel sans ajustements.
La suite dépendra de la puce et du logiciel. Le M3 Ultra est utilisé ici parce qu’il équipe le Mac compatible Thunderbolt 5 le plus rapide de cette configuration. Un futur Mac Studio avec une puce M5 Ultra pourrait améliorer le traitement des modèles si Apple conserve cette connectivité et exploite mieux les accélérateurs neuronaux du GPU, mais cette évolution reste une hypothèse.
Geerling a aussi évoqué l’intérêt potentiel de SMB Direct pour accélérer les partages réseau, notamment en montage vidéo. Pour l’instant, le jardin clos entrouvre une porte vers le calcul distribué, mais cette porte donne sur une baie de brassage et coûte presque 40 000 dollars.
Sources et références scientifiques
Malcolm Owen. AI calculations on Mac cluster get big boosts from new RDMA support on Thunderbolt 5. 2025.
Andy Chen. Mac Cluster AI Calculations Greatly Improved with New RDMA Support on Thunderbolt 5 – lonelybrand – Breaking Tech News And Reviews. 2025.
Bonjour ! Je suis Yves, un passionné de technologie et du web, âgé de 35 ans. J'adore explorer les innovations numérique et partager mes connaissances avec autrui. Mon objectif est d'aider chacun à naviguer dans l'univers digital avec aisance. Bienvenue sur mon site !
Nous utilisons des cookies pour vous garantir la meilleure expérience sur notre site web. Si vous continuez à utiliser ce site, nous supposerons que vous en êtes satisfait.